Задание №23. Кратчайший путь
Чтение рёбер из файла, сравнение длин путей и вычисление кратчайшего расстояния в ациклическом графе.
В текстовом файле перечислены направленные переходы между пронумерованными вершинами и длина каждого перехода. Требуется найти путь из вершины 1 в вершину 100 с наименьшей суммой длин, а в ответ записать целую часть этой суммы. В небольшом графе пути можно сравнить вручную; для полного файла программа последовательно вычисляет лучшие расстояния до нужных вершин. Здесь рассматривается вариант задания №23 на поиск кратчайшего пути.
Что означает строка файла
Вершины — объекты, между которыми возможны переходы. Ориентированное ребро задаёт переход только в указанном направлении. Его вес — число, которое прибавляется к длине пути при прохождении этого ребра. Путь состоит из последовательных переходов: конец каждого ребра совпадает с началом следующего. Длина пути равна сумме весов его рёбер.
В задаче о кратчайшем пути по текстовому файлу ↗ каждая строка содержит три поля L M W: начало ребра, его конец и вес. Например, строка 1 7 5.5 означает переход 1\to7 длиной 5{,}5. Обратного перехода эта строка не разрешает.
Граф ациклический, все веса положительные и не превосходят 10 000. В файле не более 200 рёбер, номера вершин — натуральные числа не больше 1000. Номера могут иметь пропуски, а строки расположены в произвольном порядке. Повторных рёбер между одной парой вершин нет. Путь из 1 в 100 гарантирован.
Ручной проход по небольшому графу
В условии приведён отдельный небольшой пример из восьми рёбер. Это иллюстрация способа решения, а не содержимое полного входного файла. Ниже сохранены все его строки.
100 12 1.0
6 7 7.0
6 1 1.0
1 7 5.5
7 100 2.0
4 100 8.0
1 100 12.0
1 4 2.5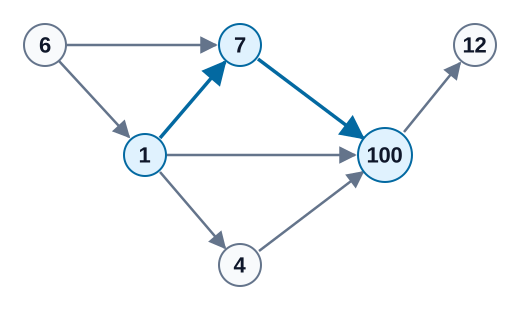
По строкам, начинающимся с 1, из стартовой вершины доступны 7, 100 и 4. Перехода в 6 нет: строка 6 1 1.0 направлена в противоположную сторону. Поэтому оба ребра, выходящие из 6, не добавляют путей из заданного старта.
Переход сразу в 100 завершает путь. Из 7 единственное продолжение ведёт в 100, из 4 — тоже в 100. Ребро 100\to12 находится уже после заданного финиша и в длину пути до 100 не включается. Так получаются все три пути от старта до финиша:
| Путь | Сумма весов |
|---|---|
| 1\to100 | 12 |
| 1\to4\to100 | 2{,}5+8=10{,}5 |
| 1\to7\to100 | 5{,}5+2=7{,}5 |
Сравниваются суммы весов, а не количество рёбер: прямой переход длиной 12 дороже пути через 7 длиной 7{,}5. Минимальная длина равна 7{,}5. У положительного числа целая часть получается отбрасыванием дробной, поэтому ответ для этого небольшого примера — 7.
Как заменить перебор путей вычислением расстояний
В большом графе разные пути могут иметь общие части. Чтобы не вычислять их заново, достаточно хранить для каждой вершины наименьшую длину пути от старта. Обозначение d(v) означает именно минимальную длину пути из 1 в вершину v. В начале ещё не пройдено ни одного ребра, поэтому d(1)=0.
Если до вершины нельзя добраться из 1, её расстояние обозначается \infty — бесконечностью. Это служебная отметка отсутствующего пути: она больше любой конечной длины. При добавлении веса она остаётся бесконечностью и не выигрывает сравнение у существующего пути.
Выбор по последнему ребру
Пусть последнее ребро пути ведёт из вершины u в вершину v и имеет вес w. Сначала нужно дойти до u, затем пройти это ребро. Лучший путь с таким последним ребром имеет длину d(u)+w. В вершину могут входить несколько рёбер, поэтому сравниваются эти суммы для всех её предшественников:
d(v)=\min_{u\to v}\bigl(d(u)+w(u,v)\bigr) при v\ne1. Здесь w(u,v) — вес ребра u\to v. Если ни один кандидат не даёт путь из старта, результат равен \infty.
В малом примере у 6 нет входящих рёбер и она не является стартом, поэтому d(6)=\infty. В 4 входит только ребро из 1 с весом 2{,}5, откуда d(4)=0+2{,}5=2{,}5. В 7 входят два ребра: из 1 с весом 5{,}5 и из 6 с весом 7. Их сравнение даёт d(7)=\min(0+5{,}5,\infty+7)=5{,}5.
Теперь известны расстояния до всех трёх предшественников финиша. Для каждого входящего в 100 ребра к найденному расстоянию добавляется его собственный вес:
| Последнее ребро | Длина кандидата |
|---|---|
| 1\to100, вес 12 | d(1)+12=0+12=12 |
| 7\to100, вес 2 | d(7)+2=5{,}5+2=7{,}5 |
| 4\to100, вес 8 | d(4)+8=2{,}5+8=10{,}5 |
Минимум этих трёх значений снова равен 7{,}5. Для получения результата использовались лучшие расстояния до предшественников; выписывать целиком каждый путь больше не требуется.
Почему вычисление можно записать рекурсивно
Рекурсия позволяет функции d(v) запросить d(u) для каждого предшественника. Например, вычисление d(100) обращается к d(7), а оно — к d(1) и d(6). Дойдя до старта или вершины без входящих рёбер, функция получает известное значение и возвращает результат предыдущему вызову.
Циклов в графе нет, поэтому такая цепочка запросов не вернётся к ещё вычисляемой вершине. Номера вершин при этом не задают порядок: он определяется рёбрами. Кеширование с помощью @cache сохраняет полученные значения. Если разные ветви обращаются к одной вершине, её расстояние вычисляется только один раз.
Программа для полного файла
Из карточки скачивается файл 23_31518.txt. Программа открывает его из текущей рабочей папки; файл должен находиться там либо в open должен быть указан путь к нему. В отличие от малого примера, это вложение содержит 200 строк. Первая строка 655 861 4582.0 уже описывает ребро: отдельного заголовка или числа рёбер в начале нет.
Сначала читается весь файл. Для каждого конца ребра сохраняется список пар «начало, вес». Например, строка 1 7 5.5 добавляет к ключу 7 предшественника 1 с весом 5{,}5. Такая структура называется списком входящих рёбер и напрямую соответствует формуле для d(v).
from decimal import Decimal
from functools import cache

incoming = {}
name = '23_31518.txt'
with open(name) as file:
    rows = file.readlines()
for line in rows:
    l, m, w = line.split()
    edge = (
        int(l), Decimal(w)
    )
    incoming.setdefault(
        int(m), []
    ).append(edge)

@cache
def d(v):
    if v == 1:
        return Decimal(0)
    edges = incoming.get(
        v, []
    )
    candidates = (
        d(u) + w
        for u, w in edges
    )
    return min(
        candidates,
        default=Decimal(
            'Infinity'
        )
    )

print(d(100))
print(int(d(100)))
readlines() считывает все строки файла в список rows. Затем цикл обрабатывает каждую строку. line.split() без аргумента разделяет строку по пробелам и табуляциям, в том числе повторяющимся. Первые два поля преобразуются в целые номера. setdefault создаёт пустой список для конца ребра, если такого ключа ещё нет; append добавляет в этот список очередную пару.
Вес преобразуется из исходной строки с помощью Decimal(w). Этот тип хранит десятичные числа и помогает избежать двоичного приближения дробей, возникающего у float. Для чисел в данном файле и в малом примере стандартной точности Decimal достаточно. Промежуточное преобразование через float здесь не нужно.
Функция сначала отдельно обрабатывает старт. Для остальных вершин incoming.get(v, []) возвращает входящие рёбра либо пустой список в переменную edges. В candidates последовательно вычисляются суммы d(u) + w для этих рёбер. Затем min выбирает наименьшую сумму. Параметр default задаёт бесконечность для пустого списка кандидатов. Если рёбра есть, но все предшественники недостижимы, их суммы тоже равны бесконечности.
Декоратор @cache действует на функцию под ним. Он запоминает результат для каждого аргумента v, поэтому второй вызов d(100) в строке вывода использует уже найденное значение. При ограничении в 200 рёбер цепочка зависимостей содержит не более 200 переходов; увеличивать стандартный предел глубины рекурсии для этого файла не требуется.
Результат на настоящем вложении
Первая строка вывода показывает минимальную длину для проверки, вторая — её целую часть для ответа:
10971.0
10971
Найденному расстоянию соответствует путь 1\to173\to975\to625\to312\to633, затем 633\to825\to96\to59\to698\to221\to56\to100. Вершина 633 повторена только на стыке двух частей записи. Веса этих рёбер по порядку: 2034, 278, 44, 193, 93, 1508, 1112, 443, 1987, 459, 2547 и 273. Их сумма равна 10 971. Проверка суммы подтверждает длину найденного пути, а выбор минимума по всем входящим рёбрам обеспечивает отсутствие более короткого.
Ответ для файла 23_31518.txt — 10971. Ответ 7 относится только к восьмистрочному примеру из условия. Все веса настоящего вложения имеют нулевую дробную часть, но это особенность файла: условие разрешает и дробные веса, что видно в малом примере.
Возможные ловушки
В задаче с направленными рёбрами и вещественными весами ↗ на результат влияют несколько деталей.
- Перевернуть ребро. Строка
6 1 1.0разрешает движение из 6 в 1. Если прочитать её наоборот, появится несуществующий путь в 6. Направление сверяется по первому и второму полям каждой строки. - Минимизировать число рёбер или вес одного ребра. Прямой путь длиной 12 содержит меньше рёбер, но проигрывает пути длиной 7{,}5. Сравнивается вся сумма; при выборе последнего ребра это d(u)+w, а не только w.
- Считать меньший номер более ранним. В полном файле есть переходы 975\to625\to312. Однократный проход по возрастанию номеров может обработать вершину до её предшественника. Правильная зависимость определяется направлением рёбер, а рекурсивный запрос вычисляет нужного предшественника первым.
- Поставить ноль недостижимой вершине. Тогда ребро из неё создаст ложного кандидата: например, из 6 в 7 появится длина 7, хотя пути из 1 в 6 нет. Ноль означает только исходное положение в 1; отсутствие пути обозначается бесконечностью.
- Округлить или усечь веса заранее. Целая часть 7{,}5 равна 7, а
round(7.5)даст 8. Отбрасывание дробей у отдельных весов тоже может изменить сумму. В программеintприменяется один раз к уже выбранной минимальной длине. - Пропустить первую строку или решить только рисунок. Первая строка файла является обычным ребром, а рисунок показывает другой, маленький граф. Сверка имени входного файла, числа прочитанных строк и двух разных результатов — 7{,}5 для примера и 10 971 для вложения — помогает разделить эти данные.